停牌动作在回合中的位置与后续判定
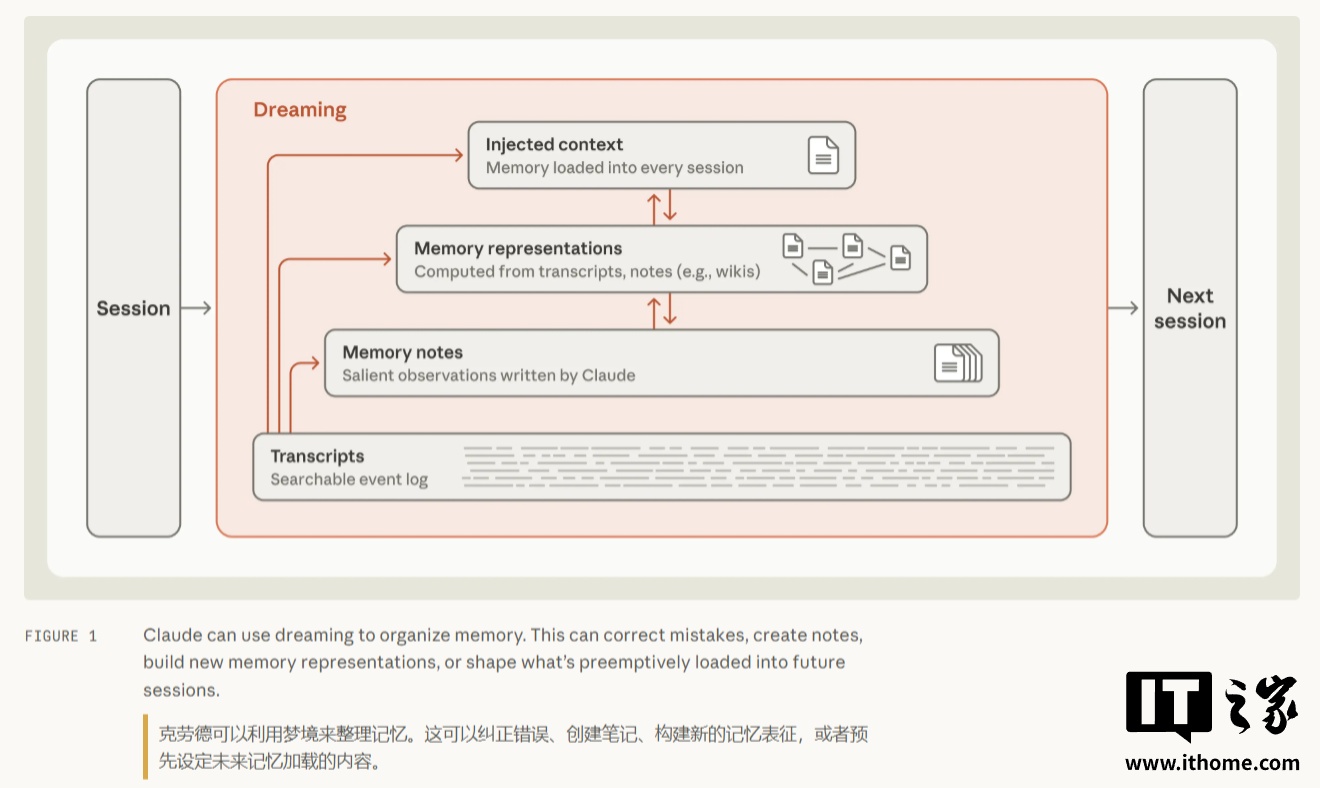
IT之家 11 月 7 日消息,Anthropic 于昨日(11 月 6 日)发布研究报告《The components of agent memory》,详细剖析了 Claude 智能体如何跨会话记忆、筛选、修正及组织知识。
研究指出,AI 智能体可以借鉴人脑在睡眠中整理记忆的机制,在空闲时段回顾历史记录、纠正错误并构建知识框架,从而大幅提升长期任务的表现。
该研究将智能体记忆划分为会话日志、记忆笔记、知识表征(如 Wiki)及注入上下文四个层次,并引入“做梦”(dreaming)机制,使模型在两次交互之间的空闲时间能回顾日志、修正错误、提炼规则并更新知识库。
研究团队认为,AI 能像人脑在睡眠中巩固记忆一样,将即时经验逐步转化为可重复使用的长期知识。Claude 会在会话中标记关键事件或写入记忆笔记,但并非所有信息都需要保存,它需要判断哪些内容在未来具有实际价值。
Anthropic 指出,记忆本质上是对未来的预测,例如记录一条已验证的规则,意味着模型预期未来会再次依赖它。
在持续学习基准 CL-Bench 的数据库问答任务中,具备记忆能力的 Claude 模型表现明显优于无记忆基线。Claude Opus 5.5 和 Sonnet 5.5 在使用记忆后,平均得分分别达到 0.838 和 0.833,而二者无记忆基线分别为 0.655 和 0.644。更强的模型能够自主形成“失败 — 反思 — 验证 — 总结规则”的学习闭环。
在《宝可梦红》游戏测试中,Anthropic 还发现“少而精”的记忆更有效。Claude Fable 5 仅维护 10 个记忆文件,却获得 4 枚徽章;而 Sonnet 3.7 写下 413 个文件,仅获得 1 枚徽章。研究认为,模型应优先保存策略、计划和经测试的规则,而非不断变化的屏幕状态。
“做梦”机制还展现出纠错能力。当 Claude 错误记录了宝可梦中心的位置并因此迷路时,系统通过比对原始会话记录修正记忆,让其最终成功抵达下一座城市;未修正记忆的运行则反复折返,未能完成目标。
在约 35 万份企业文档的测试中,Claude 通过多轮“做梦”逐步构建 Wiki。随着“做梦”规模从 2 次会话扩展到 128 次,25 个问题的达标率从 13% 提升至 48%;将 Wiki 与搜索工具结合后,综合得分从 54% 升至 61%。
Anthropic 表示,智能体记忆仍面临何时写入、如何保持更新、如何避免错误累积等挑战。未来 AI 或将更善于在完成任务后“回顾经验”,把零散交互转化为可迁移、可验证的长期知识。
IT之家附上参考地址
- The components of agent memory
相关阅读:
- 《告别知识截止日:谷歌让 AI 学会“睡觉”,边用边学还不忘旧知识》
停牌后玩家不再补牌,由庄家按固定规则补牌直至达到17点或以上,再比较点数决定胜负。
二十一点停牌专题说明动作名称、回合位置和相关判定流程,帮助读者理解这一操作之后需要关注的信息。页面通过牌局顺序与情形示例整理常见问题,将单个动作与完整规则相互连接,方便查找对应说明。相关资料结合牌面认识、点数表达和回合顺序展开,便于理解单个操作与完整流程的联系。对同一名称在不同规则版本中的用法,内容分别提示需要核对的条件,避免混合使用。读者可以从概念介绍进入具体示例,再通过常见问答查找计点、动作含义和结果判定方面的问题,逐步掌握各项说明之间的关系。
二十一点停牌深耕内容经过牌面认识与点数计算双重校验,确保信息准确可靠。领域,用心服务每一位用户。
在二十一点停牌方面,二十一点停牌提供贴心周到的支持。
二十一点停牌以21点停牌为核心,带来高效便捷的体验。
留下您的疑问